Khi bạn trò chuyện với ChatGPT và thấy câu trả lời thật gọn gàng, mạch lạc — bạn có bao giờ tự hỏi:
GPT có thực sự "suy nghĩ không" ? và nó "nghĩ" như thế nào?
Sự thật là: trước khi hiển thị kết quả cho bạn, mô hình AI thường đã “nghĩ” rất nhiều bước — nhưng bạn không bao giờ thấy phần đó.
Các mô hình AI hiện đại (như GPT-4-turbo hoặc Claude 3) bắt đầu áp dụng các kỹ thuật reasoning-based generation thay vì chỉ phản hồi “hồi đáp thẳng”.
Những bước “nghĩ ngầm” đó có sử dụng “Reasoning Tokens” – và chúng chính là yếu tố phân biệt AI phản xạ máy móc với AI thật sự có tư duy logic.
🔍 Reasoning Tokens là gì?
| Khái niệm | Diễn giải |
|---|
| Reasoning Tokens | Là những token ẩn, được mô hình sinh ra trong quá trình suy luận nội bộ, trước khi tạo ra câu trả lời cuối cùng. |
| Khác với Output Tokens | Output là phần bạn nhìn thấy. Reasoning là phần mô hình "nghĩ trong đầu" và bị loại bỏ sau khi dùng xong. |
| Không lộ diện | Người dùng không nhìn thấy reasoning tokens, trừ khi bạn yêu cầu GPT trình bày "suy nghĩ từng bước". |
| Không chiếm chỗ trong context | Điều này giúp mô hình tiết kiệm bộ nhớ cho các lượt hội thoại dài hơn. |
🧠 Vì sao reasoning tokens quan trọng?
| Lý do | Vai trò |
|---|
| ✅ Giúp mô hình suy nghĩ trước khi nói | Như con người viết nháp, reasoning tokens cho phép mô hình thử nhiều hướng, loại trừ sai sót. |
| ✅ Tăng độ chính xác của câu trả lời | Reasoning giúp mô hình xử lý logic phức tạp, đặc biệt trong toán học, lập trình, và phân tích. |
| ✅ Tránh trả lời vội vàng, sai lệch | Nếu không có reasoning, mô hình dễ "nhảy cóc", phản hồi máy móc. |
| ✅ Tối ưu hóa chi phí token | Vì reasoning bị loại sau khi sử dụng, nó không làm đầy context window. |
| ✅ Hỗ trợ multi-turn conversation | Mô hình có thể suy nghĩ theo từng lượt hội thoại mà không làm quá tải bộ nhớ ngữ cảnh. |
🧩 Hình ảnh minh họa reasoning trong hội thoại nhiều lượt
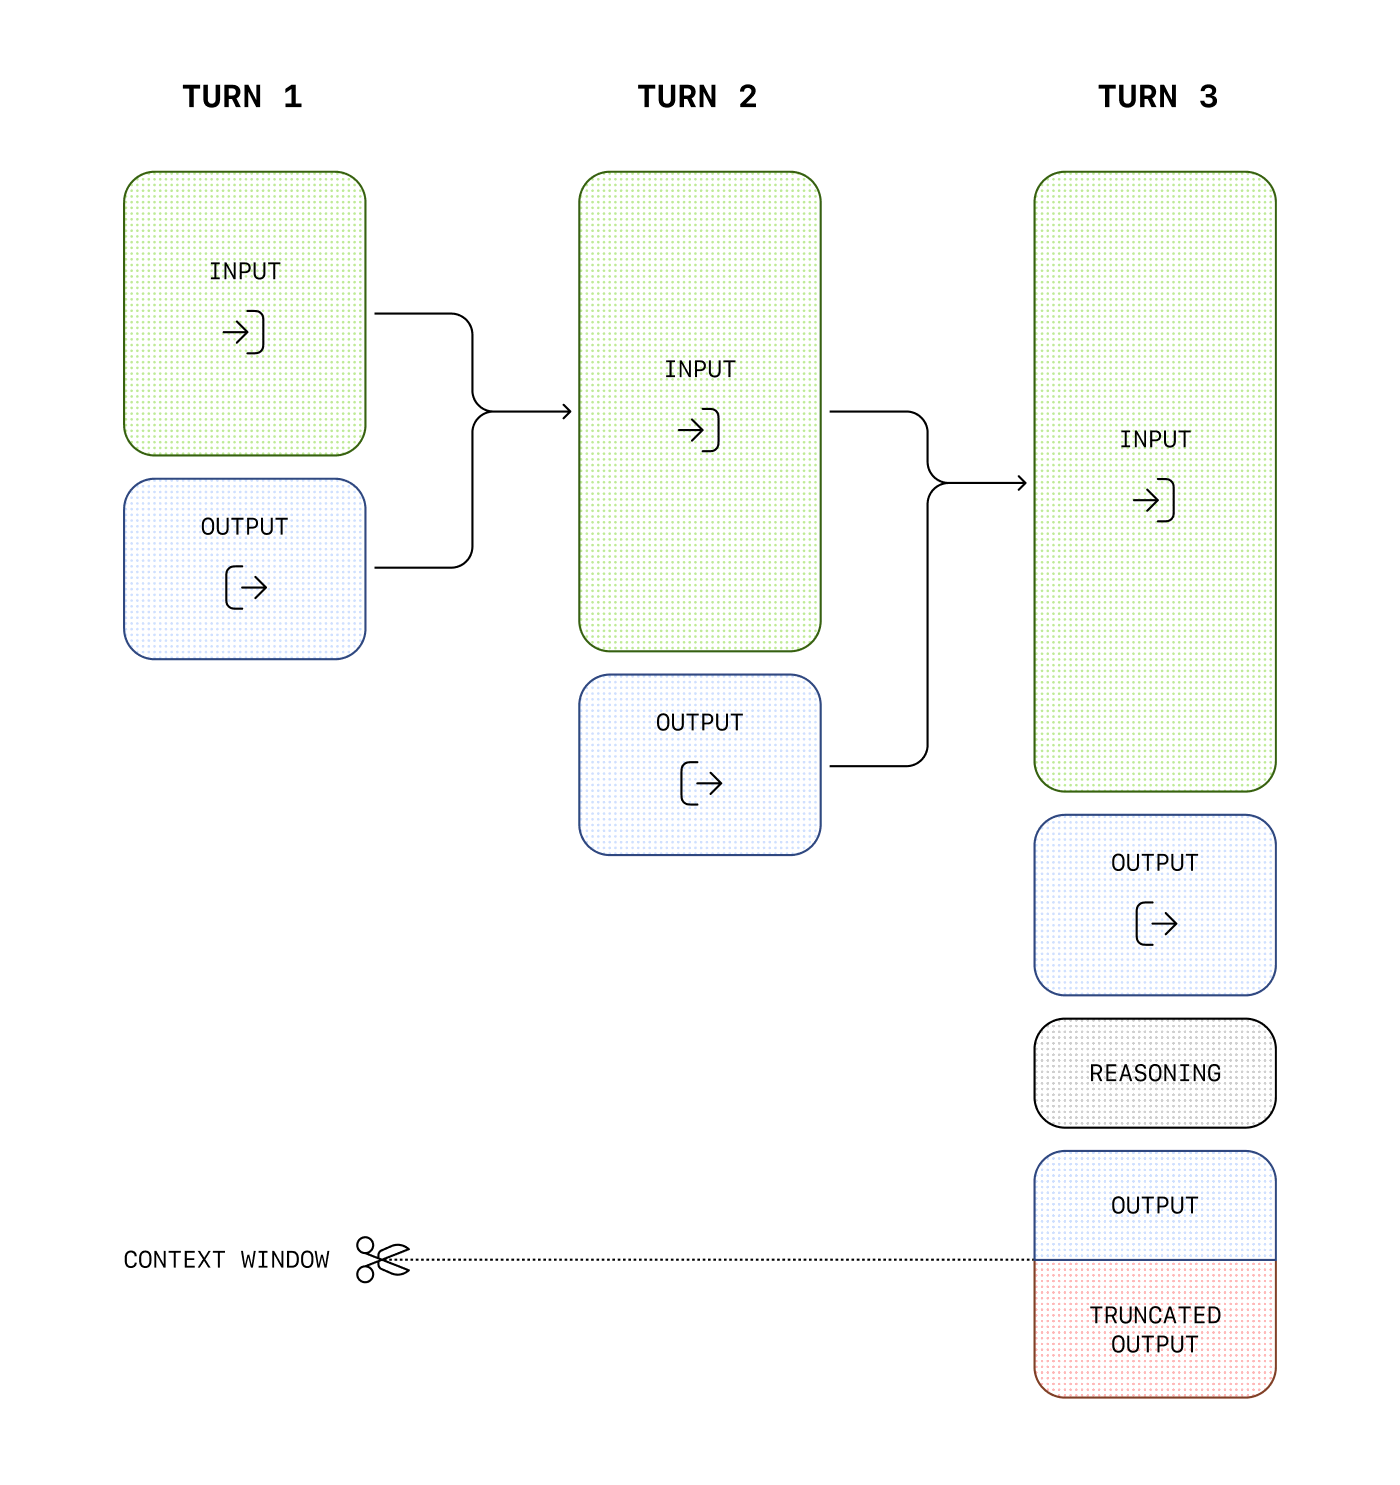
🟩 TURN 1
Input: “Tại sao bầu trời có màu xanh?”
Mô hình: sinh reasoning tokens nội bộ (ẩn) → phân tích hiện tượng tán xạ ánh sáng
Output: “Vì ánh sáng xanh tán xạ nhiều hơn các màu khác trong khí quyển.”
🟩 TURN 2
Input: “Thế tại sao hoàng hôn lại đỏ?”
Context giữ lại input + output của TURN 1
Mô hình tiếp tục reasoning → tạo output
🟩 TURN 3
✂️ Context Window & Truncated Output
| Thành phần | Giải thích |
|---|
| Context window | Là bộ nhớ tạm của mô hình, lưu lại toàn bộ input + output các lượt trước |
| Giới hạn | Tùy mô hình: 4k, 16k, 32k... đến 128k token (như GPT-4o) |
| Reasoning tokens | Không được lưu lại → không chiếm dung lượng |
| Truncated output | Các output cũ có thể bị loại bỏ khi context đầy |
🧠 Tổng quan các loại token
| Token | Vai trò |
|---|
| Input Tokens | Văn bản do người dùng nhập vào |
| Output Tokens | Câu trả lời cuối cùng mà mô hình phản hồi |
| Reasoning Tokens | Các bước “nghĩ nội bộ” – bị ẩn đi và loại bỏ sau khi dùng |
| Truncated Output | Phần output cũ bị xóa khỏi context khi token đầy |
✅ Tóm lại
Reasoning tokens là phần “nháp suy nghĩ” mà mô hình tạo ra trước khi phản hồi – không nhìn thấy, không lưu lại, nhưng cực kỳ quan trọng để AI trả lời chính xác và logic.
Nếu không có reasoning tokens, AI chỉ là một chiếc máy trả lời "vẹt".
Có reasoning, nó trở thành một đồng đội biết tư duy.
📚 Muốn thực hành reasoning thực tế?
Tại SlimAI, bạn sẽ được hướng dẫn cách kích hoạt khả năng reasoning của GPT để:
Viết content mạch lạc, logic
Thiết kế chatbot hiểu – nghĩ – trả lời
Lập kế hoạch thông minh, phân tích dữ liệu
👉 Tham gia các khóa học thực hành AI cấp tốc tại:
🔗 https://slim.vn/edu
Đừng chỉ dùng GPT để trả lời.
Hãy học cách khiến nó thật sự suy nghĩ.
